- آیا آموزش عالی ارزش سرمایه گذاری (ROI) را دارد؟
- استفاده از میانگین های متحرک هنگام سرمایه گذاری: توضیح
- کریپتوکارنسی: مقدمه ای بر خاستگاه و مکانیک آن
- مقیاس بندی خطی در مقابل لگاریتمی
- تمدید بیمه
- آشنایی با سبد سرمایه گذاری ETF
- اکوسیستم Remitone
- مبادله و هزینه های تأمین مالی
- سرمایه در گردش و نقدینگی (مسابقه تمرین)
- تجزیه و تحلیل رگرسیون خطی با استفاده از آمار SPSS

آخرین مطالب
امکانات وب


رگرسیون خطی قدم بعدی پس از همبستگی است. از آن استفاده می شود که ما می خواهیم مقدار یک متغیر را بر اساس مقدار متغیر دیگر پیش بینی کنیم. متغیری که می خواهیم پیش بینی کنیم متغیر وابسته (یا گاهی اوقات متغیر نتیجه) نامیده می شود. متغیری که برای پیش بینی مقدار متغیر دیگر استفاده می کنیم ، متغیر مستقل (یا گاهی اوقات متغیر پیش بینی کننده) نامیده می شود. به عنوان مثال ، شما می توانید از رگرسیون خطی استفاده کنید تا درک کنید که آیا می توان عملکرد امتحان را بر اساس زمان تجدید نظر پیش بینی کرد. آیا مصرف سیگار می تواند بر اساس مدت زمان سیگار پیش بینی شود. و غیرهاگر دو یا چند متغیر مستقل دارید ، و نه فقط یک ، باید از رگرسیون چندگانه استفاده کنید.
این راهنمای "شروع سریع" به شما نشان می دهد که چگونه می توانید رگرسیون خطی را با استفاده از آمار SPSS انجام دهید ، و همچنین نتایج حاصل از این آزمون را تفسیر و گزارش دهید. با این حال ، قبل از اینکه شما را با این روش آشنا کنیم ، باید فرضیات مختلفی را که داده های شما باید برآورده می شوند درک کنید تا رگرسیون خطی نتیجه معتبری به شما بدهد. ما در مورد این فرضیات بعدی بحث می کنیم.
آمار SPSS
فرض
هنگامی که شما می توانید داده های خود را با استفاده از رگرسیون خطی تجزیه و تحلیل کنید ، بخشی از این روند شامل بررسی است تا اطمینان حاصل شود که داده هایی که می خواهید تجزیه و تحلیل کنید می توانند با استفاده از رگرسیون خطی تجزیه و تحلیل شوند. شما باید این کار را انجام دهید زیرا اگر داده های شما "هفت فرض" را که برای رگرسیون خطی مورد نیاز است ، استفاده از رگرسیون خطی مناسب است. در عمل ، بررسی این هفت فرض فقط زمان کمی بیشتر به تحلیل شما می افزاید ، و شما را ملزم به کلیک بر روی چند دکمه دیگر در آمار SPSS در هنگام انجام تحلیل خود می کنید ، و همچنین کمی بیشتر در مورد داده های خود فکر کنید ، اما این استیک کار دشوار نیست.
قبل از اینکه شما را با این هفت فرض آشنا کنیم ، تعجب نکنید که هنگام تجزیه و تحلیل داده های شخصی خود با استفاده از آمار SPSS ، یک یا چند مورد از این فرضیات نقض می شود (یعنی ملاقات نکرده است). این غیر معمول نیست هنگام کار با داده های دنیای واقعی به جای نمونه های کتاب درسی ، که اغلب فقط به شما نشان می دهد که چگونه می توانید رگرسیون خطی را انجام دهید وقتی همه چیز خوب پیش می رود! با این حال ، نگران نباشید. حتی هنگامی که داده های شما فرضیات خاصی را از دست می دهد ، اغلب راه حلی برای غلبه بر این وجود دارد. اول ، بیایید نگاهی به این هفت فرض بیندازیم:
- فرض شماره 1: متغیر وابسته شما باید در سطح مداوم اندازه گیری شود (به عنوان مثال ، این یک متغیر فاصله یا نسبت است). نمونه هایی از متغیرهای مداوم شامل زمان تجدید نظر (اندازه گیری در ساعت) ، هوش (اندازه گیری شده با استفاده از نمره ضریب هوشی) ، عملکرد امتحان (اندازه گیری از 0 تا 100) ، وزن (اندازه گیری شده در کیلوگرم) و غیره است. در مقاله ما می توانید در مورد متغیرهای فاصله و نسبت اطلاعات بیشتری کسب کنید: انواع متغیر.
- فرض شماره 2: متغیر مستقل شما نیز باید در سطح مداوم اندازه گیری شود (به عنوان مثال ، این یک متغیر فاصله یا نسبت است). برای نمونه هایی از متغیرهای مداوم ، به گلوله بالا مراجعه کنید.
- فرض شماره 3: باید بین این دو متغیر رابطه خطی برقرار شود. در حالی که چندین روش برای بررسی اینکه آیا یک رابطه خطی بین دو متغیر شما وجود دارد ، وجود دارد ، ما پیشنهاد می کنیم با استفاده از آمار SPSS یک پراکندگی ایجاد کنید که در آن بتوانید متغیر وابسته را در برابر متغیر مستقل خود ترسیم کنید و سپس از نظر بصری از پراکندگی برای بررسی خطی استفاده کنید. پراکندگی شما ممکن است چیزی شبیه به موارد زیر باشد:
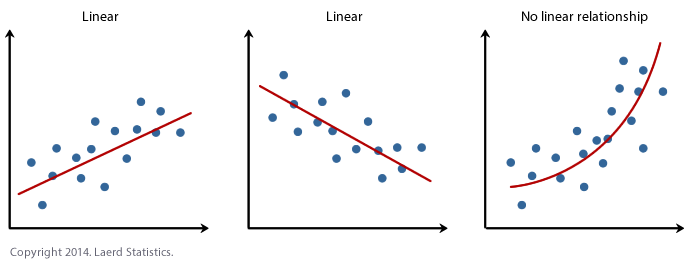
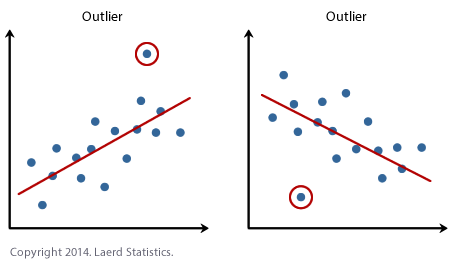
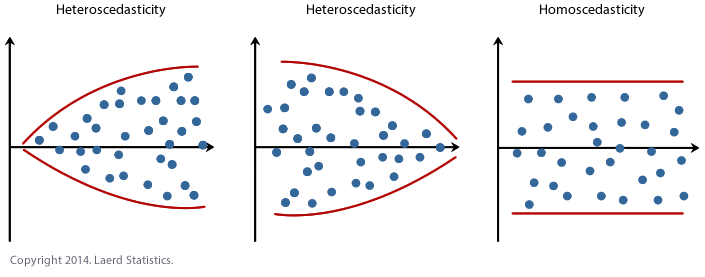
با استفاده از آمار SPSS می توانید فرضیات #3 ، #4 ، #5 ، #6 و #7 را بررسی کنید. فرضیات شماره 3 باید ابتدا قبل از حرکت روی فرضیات شماره 4 ، شماره 5 ، شماره 6 و شماره 7 بررسی شود. ما پیشنهاد می کنیم فرضیات را به این ترتیب آزمایش کنید زیرا فرضیات شماره 3 ، شماره 4 ، #5 ، شماره 6 و شماره 7 شما را ملزم می کند که ابتدا روش رگرسیون خطی را در آمار SPSS اجرا کنید ، بنابراین پس از بررسی فرض شماره 1 ، راحت تر می توانید با این موارد برخورد کنیدو شماره 2فقط به یاد داشته باشید که اگر تست های آماری را روی این فرضیات به درستی اجرا نکنید ، نتایج حاصل از اجرای رگرسیون خطی ممکن است معتبر نباشد. به همین دلیل ما تعدادی از بخش های راهنمای رگرسیون خطی پیشرفته خود را برای کمک به شما در بدست آوردن این حق اختصاص می دهیم. شما می توانید اطلاعات بیشتری در مورد محتوای پیشرفته ما به عنوان یک کل در ویژگی های ما کسب کنید: صفحه نمای کلی یا به طور خاص تر ، یاد بگیرید که چگونه ما در آزمایش فرضیات در ویژگی های خود کمک می کنیم: صفحه فرضیات.
در بخش ، روش ، ما روش آمار SPSS را برای انجام رگرسیون خطی نشان می دهیم با فرض اینکه هیچ فرضیه ای نقض نشده است. ابتدا نمونه ای را که در این راهنما استفاده می شود معرفی می کنیم.
آمار SPSS
مثال
یک فروشنده برای یک برند بزرگ اتومبیل می خواهد مشخص کند که آیا بین درآمد یک فرد و قیمت آنها برای یک ماشین رابطه وجود دارد یا خیر. به همین ترتیب ، "درآمد" فرد متغیر مستقل است و "قیمت" آنها برای یک ماشین پرداخت می کنند ، متغیر وابسته است. فروشنده می خواهد از این اطلاعات استفاده کند تا مشخص کند کدام اتومبیل برای ارائه مشتریان بالقوه در مناطق جدید که درآمد متوسط در آن شناخته شده است.
آمار SPSS
راه اندازی در آمار SPSS
در آمار SPSS ، ما دو متغیر ایجاد کردیم تا بتوانیم داده های خود را وارد کنیم: درآمد (متغیر مستقل) و قیمت (متغیر وابسته). همچنین می تواند برای ایجاد یک متغیر سوم به نام Caseno ، به عنوان یک شماره مورد زمانی مفید باشد. این متغیر سوم برای از بین بردن موارد (به عنوان مثال ، مسافت های قابل توجه) که هنگام بررسی فرضیات شناسایی کرده اید ، برای شما آسان می کند. با این حال ، ما آن را در روش آمار SPSS که در زیر آمده است ، درج نمی کنیم زیرا فرض می کنیم شما قبلاً این فرضیات را بررسی کرده اید. در راهنمای رگرسیون خطی پیشرفته ، ما به شما نشان می دهیم که چگونه می توانید داده ها را در آمار SPSS وارد کنید تا هنگام بررسی فرضیات ، رگرسیون خطی را اجرا کنید. شما می توانید در مورد محتوای پیشرفته تنظیم داده های ما در ویژگی های ما: صفحه تنظیم داده ها یاد بگیرید. از طرف دیگر ، به راهنمای عمومی ، "شروع سریع" ما مراجعه کنید: وارد کردن داده ها در آمار SPSS.
آمار SPSS
روش آزمایش در آمار SPSS
پنج مرحله زیر به شما نشان می دهد که چگونه می توانید داده های خود را با استفاده از رگرسیون خطی در آمار SPSS تجزیه و تحلیل کنید وقتی که هیچ یک از هفت فرض در بخش قبلی ، فرضیات ، نقض نشده است. در پایان این چهار مرحله ، ما به شما نشان می دهیم که چگونه می توانید نتایج را از رگرسیون خطی خود تفسیر کنید. اگر به دنبال کمک هستید تا اطمینان حاصل کنید که داده های شما فرضیات #3 ، #4 ، #5 ، #6 و #7 را که هنگام استفاده از رگرسیون خطی مورد نیاز هستند ، مطابقت می دهد و می توانید با استفاده از آمار SPSS آزمایش کنید ، می توانید در مورد پیشرفته ما اطلاعات بیشتری کسب کنیدراهنماهای مربوط به ویژگی های ما: صفحه نمای کلی.
توجه: روشی که در زیر آمده است برای نسخه های SPSS آمار 18 تا 28 و همچنین نسخه اشتراک آمار SPSS یکسان است ، با نسخه 28 و نسخه اشتراک آخرین نسخه های آمار SPSS است. با این حال ، در نسخه 27 و نسخه اشتراک ، آمار SPSS ظاهر جدیدی را به رابط آنها به نام "SPSS Light" معرفی کرد و نگاه قبلی را به نسخه های 26 و نسخه های قبلی جایگزین کرد که "SPSS Standard" نامیده می شد. بنابراین ، اگر نسخه های آمار SPSS 27 یا 28 (یا نسخه اشتراک آمار SPSS) را دارید ، تصاویر زیر به رنگ خاکستری روشن و نه آبی هستند. با این حال ، این روش یکسان است.
- کلیکAnalyze>Regression>Lدروندر منوی بالا ، همانطور که در زیر آمده است:
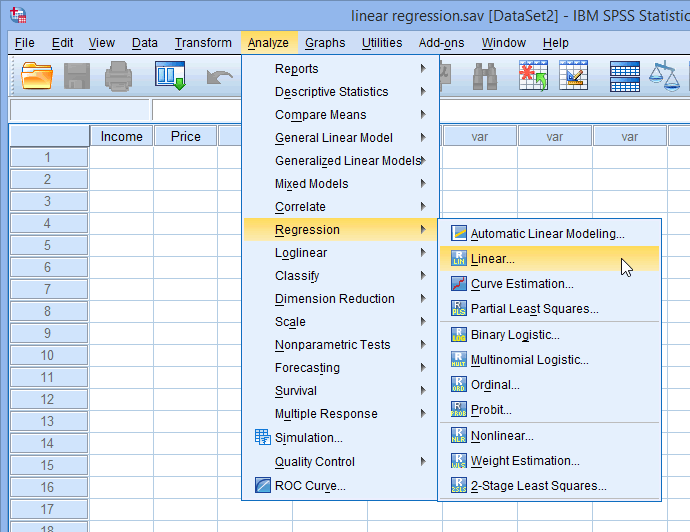
منتشر شده با مجوز کتبی از آمار SPSS ، شرکت IBM.
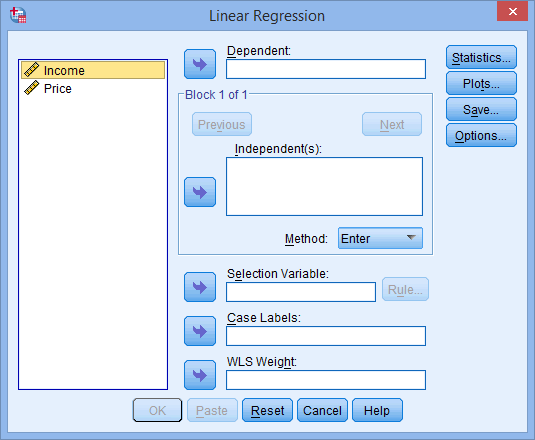
با کادر گفتگوی رگرسیون خطی به شما ارائه می شود:
منتشر شده با مجوز کتبی از آمار SPSS ، شرکت IBM.
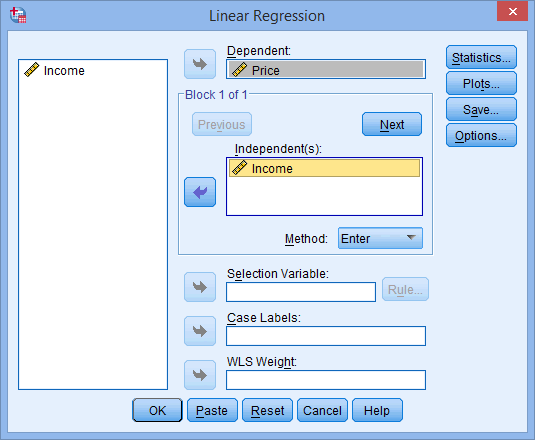
متغیر مستقل ، درآمد را بهINDEPENTENT (ها): جعبه و متغیر وابسته ، قیمت ، بهDحماسه: جعبه. می توانید این کار را با کشیدن و رها کردن متغیرها یا با استفاده از دکمه های مناسب انجام دهید. شما در پایان با صفحه زیر قرار خواهید گرفت:
منتشر شده با مجوز کتبی از آمار SPSS ، شرکت IBM.
- اکنون باید چهار فرضیه مورد بحث در بخش فرضیات فوق را بررسی کنید: هیچ دور مهم (فرض شماره 3). استقلال مشاهدات (فرض شماره 4) ؛همسایه (فرض شماره 5) ؛و توزیع عادی خطاها/باقیمانده ها (فرضیات شماره 6). شما می توانید این کار را با استفاده از ویژگی ها و سپس انتخاب گزینه های مناسب در این دو جعبه گفتگو انجام دهید. در راهنمای رگرسیون خطی پیشرفته ما ، به شما نشان می دهیم که کدام گزینه ها را انتخاب کنید تا آزمایش کنید که آیا داده های شما این چهار فرض را برآورده می کند یا خیر.
- روی دکمه کلیک کنید. این نتایج را ایجاد می کند.
دسترسی به همه 96 راهنمای آمار SPSS در آمار LAERD
گزینه های باینری...
ما را در سایت گزینه های باینری دنبال می کنید
برچسب :
نویسنده : هایده حائری
بازدید : <-PostHit->
آرشیو مطالب
خبرنامه
